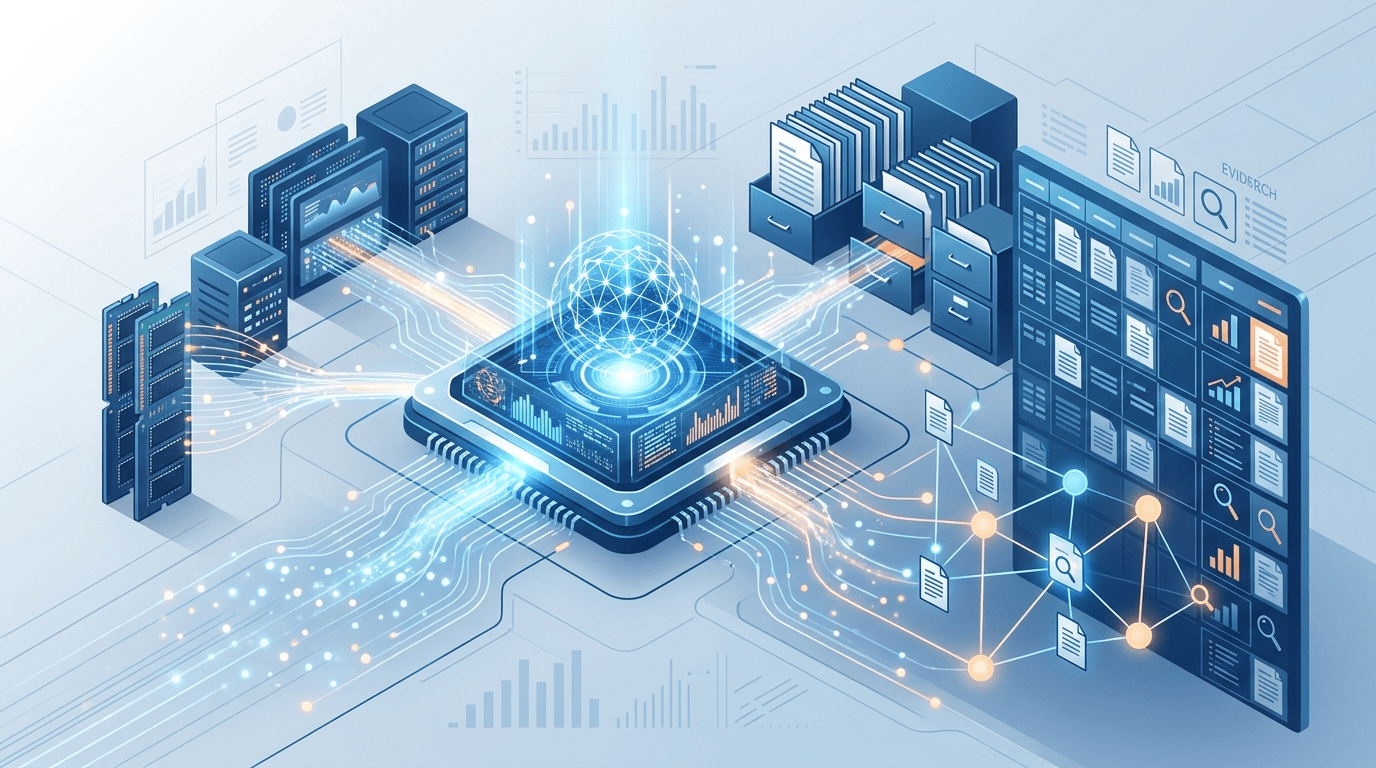
새로운 검색 인공지능 기술이 등장했습니다. 기존 인공지능이 검색 과정에서 모든 작업을 혼자 처리하던 방식에서 벗어나, 기억과 정리 업무는 외부 시스템에 맡기고 검색과 분석에만 집중하도록 만든 것이 핵심입니다.
미국 일리노이대학교와 UC 버클리, 크로마 연구팀이 함께 개발한 ‘하네스-1’이라는 검색 인공지능 시스템이 최근 공개되었습니다. 이 시스템은 200억 개 규모의 매개변수를 가진 오픈소스 모델을 기반으로 만들어졌습니다.
개발팀은 대부분의 검색 인공지능이 너무 많은 일을 동시에 처리한다고 지적했습니다. 정보를 찾는 것뿐만 아니라 어떤 문서를 확인했는지, 어떤 내용이 중요한지, 무엇을 검증했는지까지 모두 스스로 기억해야 하기 때문에 효율이 떨어진다는 설명입니다.
상태 기반 검색 하네스라는 새로운 구조를 통해 이 문제를 해결했습니다. 인공지능은 무엇을 검색하고 어떤 정보를 확인할지 판단하는 데 집중하고, 하네스 시스템이 작업 기록과 자료 관리를 담당하는 역할 분담 방식입니다.
개발팀은 이를 ‘상태 기반 인지 오프로딩’이라고 부릅니다. 연구자가 복잡한 연구를 할 때 모든 자료를 머릿속에만 기억하지 않고 메모장과 서류함에 정리해두며 분석과 판단에 집중하는 것과 같은 원리입니다.
하네스 시스템은 검색 과정에서 모은 정보를 체계적으로 관리합니다. 검색된 문서를 후보 저장소에 보관하고, 중요도에 따라 핵심 문서를 분류하며, 어떤 정보가 어느 문서에서 나왔는지 연결해주는 증거 기록을 저장합니다. 중복되거나 불필요한 내용은 자동으로 정리됩니다.
특히 사람 이름, 날짜, 연도 같은 핵심 정보를 자동으로 추출해서 문서 간 연관성을 시각적으로 보여주는 ‘증거 그래프’ 기능을 제공합니다. 이를 통해 인공지능은 방대한 정보를 일일이 기억하는 대신 정리된 정보를 바탕으로 필요한 문서를 찾고 사실을 확인하는 데 집중할 수 있습니다.
하네스-1은 검색 과정에서 8개의 전용 도구를 활용합니다. 문서를 검색한 뒤 내용을 읽고, 중요 정보를 선별하고 검증한 뒤 최종 결과를 정리하는 과정을 단계적으로 수행합니다.
‘웜 스타트’ 기능도 주목할 만합니다. 일반적인 검색 시스템이 처음부터 모든 정보를 직접 수집해야 하는 것과 달리, 하네스-1은 첫 번째 검색에서 확보한 주요 문서들을 자동으로 초기 문서 집합에 포함합니다. 이후 인공지능이 가치 있는 문서를 추가하거나 불필요한 문서를 제거하면서 결과를 점진적으로 개선해 나갑니다.
학습 방식도 차별화됩니다. GPT-5.4를 교사 모델로 활용해 하네스 환경에서 생성한 899개의 검색 경로만으로 감독 미세조정을 수행했고, 미국 증권거래위원회 공시 문서 검색 과제를 중심으로 강화학습을 진행했습니다.
주목할 점은 학습 데이터 규모입니다. 하네스-1은 감독 미세조정용 899개 경로와 강화학습용 3,453개 질의를 포함해 약 4,400개의 데이터만으로 학습되었습니다. 이는 기존 오픈소스 검색 시스템이 수만에서 수십만 건의 학습 데이터를 사용한 것과 비교하면 훨씬 작은 규모입니다.
예를 들어 컨텍스트-1은 17,000건 이상, 서치-R1은 22만 건이 넘는 데이터를 활용했습니다. 반면 하네스-1은 약 4,400개의 데이터만으로도 더 높은 성능을 기록하며 뛰어난 데이터 효율성을 입증했습니다.
성능도 뛰어납니다. 웹 검색, 금융 문서, 특허 데이터베이스, 다단계 질의응답 등 8개 평가 기준에서 테스트를 진행했습니다.
핵심 지표인 큐레이션 리콜에서 하네스-1은 평균 0.730을 기록하며 오픈소스 검색 시스템 가운데 최고 성능을 달성했습니다. 이는 기존 최고 수준 오픈소스 모델인 퉁이 딥리서치 30B보다 11.4%포인트 높은 수치입니다.
일부 평가에서는 GPT-5.4, 클로드 소네트 4.6, 키미-K2.5 등 훨씬 큰 규모의 상용 모델들을 능가했으며, 평가 대상 가운데 클로드 오퍼스 4.6만이 근소하게 앞선 것으로 나타났습니다.
특히 일반화 성능이 눈에 띕니다. 강화학습 과정은 증권거래위원회 공시 문서 검색 과제에만 적용되었지만, 실제 평가에서는 학습에 사용되지 않은 기준에서 더 큰 성능 향상이 나타났습니다. 학습에 활용된 기준에서는 기존 오픈소스 모델 대비 7.9%포인트 높은 성능을 기록한 반면, 학습에 포함되지 않았던 기준에서는 17%포인트의 성능 향상을 보였습니다.
개발팀은 이를 통해 특정 데이터나 분야에 맞춰 검색 전략을 암기한 것이 아니라 검색 과정 자체를 효율적으로 수행하는 능력을 학습한 결과라고 분석했습니다.
하네스-1은 질문에 직접 답변을 생성하는 범용 모델은 아닙니다. 대신 후속 생성형 인공지능이 활용할 수 있도록 신뢰도 높은 문서와 증거를 선별하고 정리하는 검색 전용 역할에 집중합니다.
개발팀은 이러한 접근 방식이 대량의 문서를 검토해야 하는 업무에서 특히 강점을 발휘할 것으로 기대하고 있습니다. 학술 논문과 특허 조사, 기업 재무제표와 증권거래위원회 공시 분석, 다단계 팩트체크, 기업용 지식 검색 시스템 등에 활용할 수 있습니다.
모델과 하네스 코드는 모두 아파치 2.0 라이선스로 허깅페이스와 깃허브에 공개되었습니다. 따라서 기업들은 상업용 서비스나 사내 검색 시스템에 자유롭게 통합할 수 있습니다.